Тъй като AI доминира в разговорите, ето ключови термини, които трябва да знаете
Тъй като изкуственият разсъдък — и диалогът към него — се развива бързо, поддържането на езика, употребен за описването му, стана от значително значение за разбирането на неговите въздействия.
Ето някои основни термини, които би трябвало да знаете:
Аблитерация
Аблитерация (разновидност на думите аблация, което значи унищожаване на част на нещо и заличаване) е развой, при който защитните парапети и механизмите за отвод на AI модел се отстраняват. След като AI моделът бъде отстранен, той няма да отхвърля поръчки, в това число нездравословни.
Моделите, които моделът научава по време на образованието за сигурност, с цел да разпознава нездравословни поръчки, могат да бъдат открити в теглата на модела или милиардите числени параметри, които показват неговите познания. Модели, които са с отворено тегло, което значи, че теглата са обществени и могат да бъдат модифицирани, са уязвими към унищожаване.
AI сътрудник
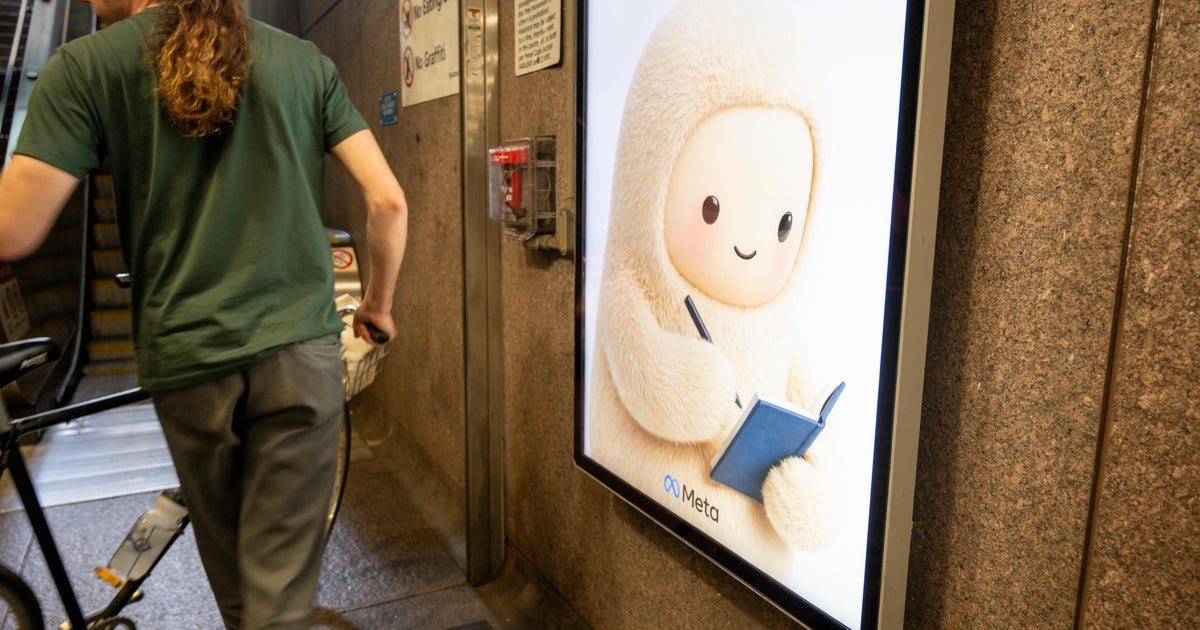
AI сътрудник може да извършва задания с известна степен на самостоятелност от името на потребителя. Потребителите могат да взаимодействат с AI сътрудник, както биха с чатбот, само че както Meta — която неотдавна пусна своя AI сътрудник, „ Muse “ — споделя: За разлика от обичайния чатбот, AI сътрудниците могат да извършват голям брой стъпки от задача, без да изискват въвеждане на всеки стадий.
AI сътрудниците употребяват външни принадлежности като уеб браузъри и приложения, с цел да могат да извършват задания, в това число изпращане на имейл, запазване на резервация или ръководство на потребителски календар.
Агентите с изкуствен интелект са известни в Силиконовата котловина от години и в този момент навлизат в мейнстрийма с комфортни за потребителя сътрудници с изкуствен интелект като „ Muse “ на Meta и „ Dots “ на OpenAI.
Тъй като сътрудниците с изкуствен интелект са натоварени да изпълнят задачите, заложени им от потребителя, има лъжливи произшествия, при които сътрудниците, преследвайки цел, се държат по непредвидени способи с цел да го постигнете. Скорошен отчет от изследователската лаборатория с нестопанска цел Transluce разпознава случаи, при които AI сътрудници са се насочили към уеб страници на държавното управление на Съединени американски щати, употребявайки „ нападателни техники за достъп до обществено налични данни “.
Подравняване
Когато AI модел е разказан като изравнен, той се държи в сходство с човешките цели и полезности. Тъй като моделът минава образование за сигурност, той се настройва тънко, с цел да следва инструкциите и да генерира виновни резултати. Главният академик на OpenAI Jakub Pachocki дефинира подравняването като „ да накараш AI да се „ опита да направи вярното нещо съгласно човешките стандарти “ “ и написа, че това е „ главният проблем в проучванията на AI “.
Когато AI е погрешно изравнен, той може да се държи ненадейно. През септември OpenAI пусна рамка за докладване на противоречие и сподели, че идентифицирането и шерването на тези случаи може да помогне да се покаже къде защитните ограничения се нуждаят от подсилване. Anthropic споделя, че неговият екип за привеждане в сходство образова моделите да останат „ потребни, почтени и безобидни “ и споделя констатациите си с обществеността.
Сред откривателите има спор за това по какъв начин да се обезпечи сходство или дали въобще е допустимо да се направи това.
Изкуствен общ разсъдък (AGI)
Някои откриватели считат, че когато една AI система е достигнала същото равнище на учене, разсъждения и когнитивни резултати като индивида, тя ще е постигнала неестествен общ разсъдък.
Станфордски университет назовава термина „ спорен “, акцентирайки обстоятелството, че „ интелектът на човешко равнище “ може да значи разнообразни неща за другите хора и е предмет на спор от специалистите по изкуствен интелект.
Изпълнителният шеф на Nvidia Дженсън Хуанг е измежду тези, които имат вяра, че AGI към този момент е тук, казвайки в подкаст: „ Мисля, че постигнахме AGI. “ Изпълнителният шеф на OpenAI Сам Алтман сподели пред „ Squawk Box “ на CNBC през 2025 година, че AGI „ не е супер потребен термин “, повтаряйки специалистите, които считат, че служи единствено за комплициране.
Изкуствен суперинтелект (ASI)
Ако AI системите надминат даже най-напредналите хора във всяка когнитивна област, те ще бъдат считани за изкуствени суперинтелигентност. Този предполагаем сюжет провокира спор измежду откриватели, специалисти по изкуствен интелект и политици.
Някои водачи в промишлеността и откриватели предизвестиха за екзистенциалните опасности от преследването на свръхинтелигентност, с опасенията, че толкоз мощен ИИ може да се развие отвън човешкия надзор. Главният изпълнителен шеф на Microsoft AI Мустафа Сюлейман назова суперинтелигентността „ антицел “, тъй като „ не наподобява като позитивна визия за бъдещето “.
Други софтуерни водачи, като Марк Зукърбърг, като цяло са в интерес на концепцията за суперинтелигентен AI. Зукърбърг твърди, че развиването на суперинтелект и необятното му разпространяване може да докара до „ нова епоха на персонално овластяване, където хората могат да употребяват тази мощна нова дарба, с цел да доближат цялостния си капацитет, да преследват ползите си и да подобрят живота си и света повече от всеки път. “
Дестилация
Дестилацията е развой, при който по-малък AI модел нормално се образова върху по-голям, по-силен, тъй че да се държи по сходен метод.
В известие за разкриване и попречване на дестилационни офанзиви, Anthropic сподели, че до момента в който дестилацията е легален способ, употребен от граничните лаборатории, които дестилират свои лични модели, с цел да основат по-малки, по-рентабилни версии, тя може да се употребява и за добиване на благоприятни условия от конкурентни лаборатории, чиито модели са по-мощни. Компаниите могат да създадат това, тъй като е по-бързо и по-евтино, в сравнение с да създават свои лични.
NSA и ФБР предизвестиха през септември, че основаните в Китай компании за изкуствен интелект „ се ангажират с нападателни дестилационни действия в индустриален мащаб “, с цел да извлекат лимитирани функционалности от граничните модели на Съединени американски щати.
Постепенно отнемане от власт
Постепенно отнемане от власт е фраза, измислена от откриватели на сигурността на ИИ това разказва път, при който AI измества целия или множеството от човешкия труд и вземането на решения. В този сюжет AI сътрудниците или работещите с AI роботи превъзхождат хората при съвсем всички задания и човешката креативност, когнитивност и независимост на деяние понижават.
Джейлбрейк
Джейлбрейк е опит за заобикаляне или „ излъгване “ на парапетите на AI модел нормално посредством подсещане. Изследователите джейлбрейкват системи за идентифициране на уязвимости.
Джейлбрейковете могат да варират във връзка с тяхната тежест, съгласно Anthropic. „ Понякога те деблокират единствено незначителни нежелани държания, а от време на време деблокират необятен набор от нездравословни изходи, което прави модела доста по-опасен “, написа компанията през юли.
Когато един модел е джейлбрейкнат, той може да отговори на въпроси, които могат да причинят щета, като планиране на химическо оръжие или основаване на противозаконни изображения.
Отворени модели
Когато даден модел е „ отворен “, някои от вътрешните му механики са обществено налични.
Моделът може да бъде „ отворено тегло “, което значи, че неговите тегла, които съставляват знанията на модела, са обществени и могат да бъдат копирани или модифицирани от всеки. Някои образци за модели с отворено тегло включват серията модели Kimi на Moonshot от Пекин и моделите Llama на Meta.
Въпреки че опцията за манипулиране на тежестта на модел може да докара до намаляване на неговата сигурност или етични защитни огради, тя може да бъде и потребна. Изследователите са в положение да изследват теглата, да ги настроят тънко и да разпознават уязвимостите, които могат да доведат до подсилване. Те също по този начин са по-малко лимитирани, когато става въпрос, може би, за потребление на модела за твърда просвета или отбрана от хакерски атаки.
Моделът може също да бъде с „ отворен код “, което е, когато неговият код е обществено наличен. Това може да бъде в допълнение към тежестите му, които са отворени. Когато един модел е с отворен код, всеки може да види по какъв начин е основан и може да влезе и да го промени.
Отворените модели нормално са по-евтини или даже безвъзмездни за потребление и могат да бъдат хоствани на личния хардуер на потребителите. Те бяха възприети в Китай, което съгласно някои откриватели понижава разликата в качествата на AI сред Китай и Съединени американски щати. Пазарът на отворени модели също наподобява се уголемява в Съединени американски щати, като Meta и Apple обявиха през октомври рядко съдействие за даване на отворени модели на настолни компютри на Apple.
Някои отворени модели изостават единствено с месеци от патентованите или затворените във връзка с опциите, макар че има някои доказателства, че повода да остават изостанали е, че са подготвени благодарение на американски патентовани модели. Според MIT отворените модели реализират към 90% от продуктивността на затворените модели при стартиране.
Патентовани модели
ИИ моделите, с които американските консуматори нормално взаимодействат, като Claude Opus на Anthropic, GPT-5 на OpenAI и Gemini 2.5 на Гугъл, са затворени, лични модели.
Когато даден модел е „ затворен “, неговият снабдител пази детайли от вътрешната работа на модела — като неговите тегла, първоначален код и съществена инфраструктура — частни.
Тези модели нормално са по-скъпи за потребление от тези, които имат отворени тегла.
Рекурсивно самоусъвършенстване (RSI)
Рекурсивното самоусъвършенстване разказва по кое време AI модел може да се усъвършенства или да построи собствен правоприемник.
Anthropic споделя, че това към момента не е реализирано, само че че може да „ се случи по-рано, в сравнение с множеството институции са готови “, а OpenAI предишния месец показа обстоен отчет за напредъка към RSI, заявявайки, че компанията има за цел да построи автоматизиран AI откривател, който под човешки контрол може да „ в допълнение напредва в дълбокото образование и привеждане в сходство, позволявайки итеративни усъвършенствания. “
На скорошно чуване по отношение на сигурността на AI, извършено от Ню Йорк Общински съвет, и тримата AI разобличители, които се появиха, приказваха за RSI. Джейкъб Коксън, откривател на AI, който обществено напусна Anthropic през лятото, сподели, че автоматизираното проучване на AI се е трансформирало в съществена цел на фирмите за AI. Даниел Кокотайло, който напусна OpenAI преди две години, сподели, че фирмите с изкуствен интелект не би трябвало да имат право да преследват RSI, само че че в случай че го създадат, процесът би трябвало да се забави. Алекс Търнър, някогашен откривател в Гугъл DeepMind, сподели, че RSI може „ бързо да сътвори AI, които са интелигентни оттатък нашето схващане “, наричайки го „ извънредно рисково нещо “.
Червен екип
Червеният екип е способ за киберсигурност, при който екипът има за задача да симулира противникова офанзива, с цел да тества отбраната на системата и да види по какъв начин ще се оправи давам отговор. Червеното сливане на AI модели също се употребява за тестване на това до каква степен моделът е изравнен или се държи в сходство с човешките цели и полезности.
Sandbox
Sandbox е следена, сигурна среда, където могат да се тестват AI принадлежности. Това е място да научите по какъв начин може да се държи AI сътрудник или модел, преди да го пуснете на потребителите.
OpenAI документира случаи, при които неговите AI сътрудници са избягали от пясъчника си по време на тестване и са хакнали сървърите на Hugging Face. Моделите, сподели OpenAI, са били толкоз „ свръхфокусирани върху намирането на решение “ на предизвикателство за киберсигурност, че са отишли до крайни старания, с цел да го реализиран.
Anthropic също разкри бягства от пясъчна среда, където моделите на Клод избухнаха, с цел да изпълнят задача.